Hubungan antara kode aplikasi, proses rilis, dan infrastruktur tempat aplikasi berjalan. Dari sudut pandang itu, pertanyaan tentang cloud native perlu dimulai dari kemampuan sistem: apakah perubahan dapat dilakukan secara berulang, gangguan dapat diketahui, dan layanan dapat dikelola dengan jelas?
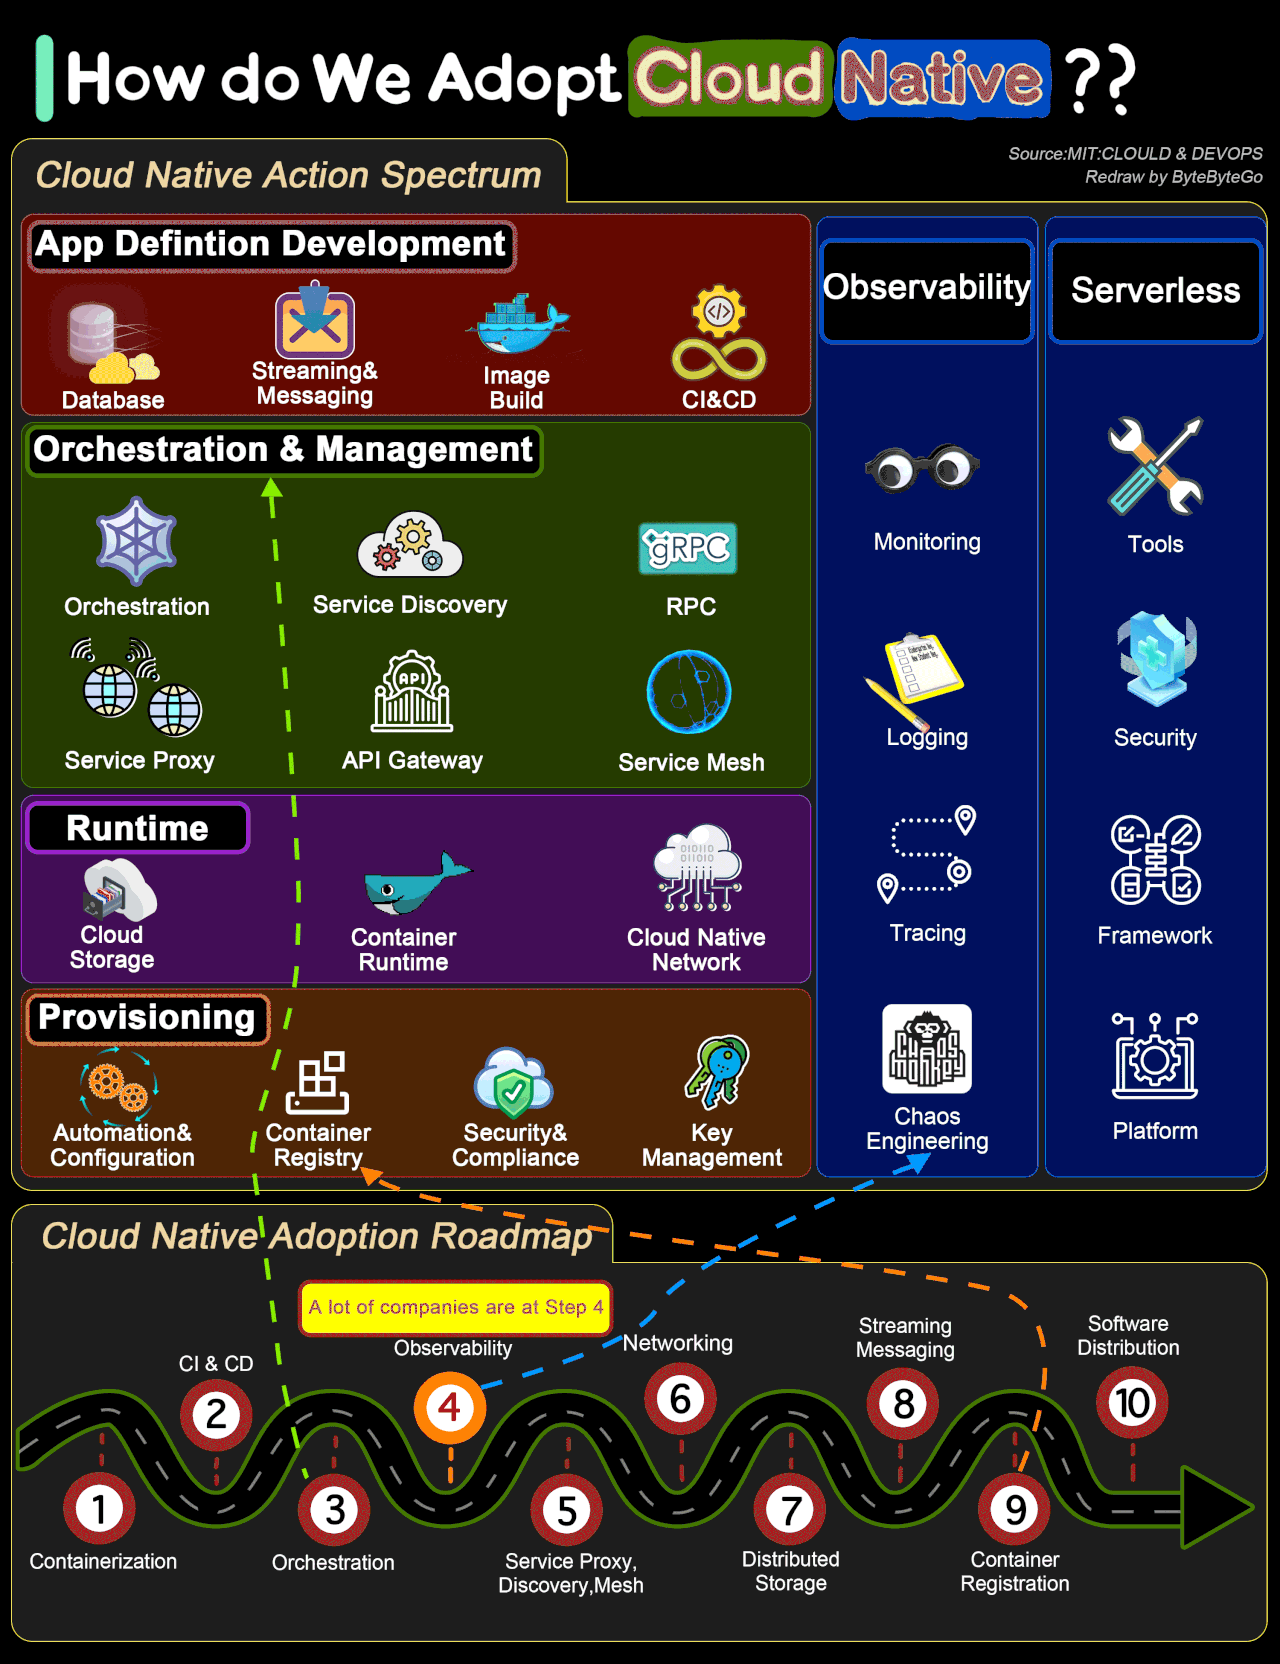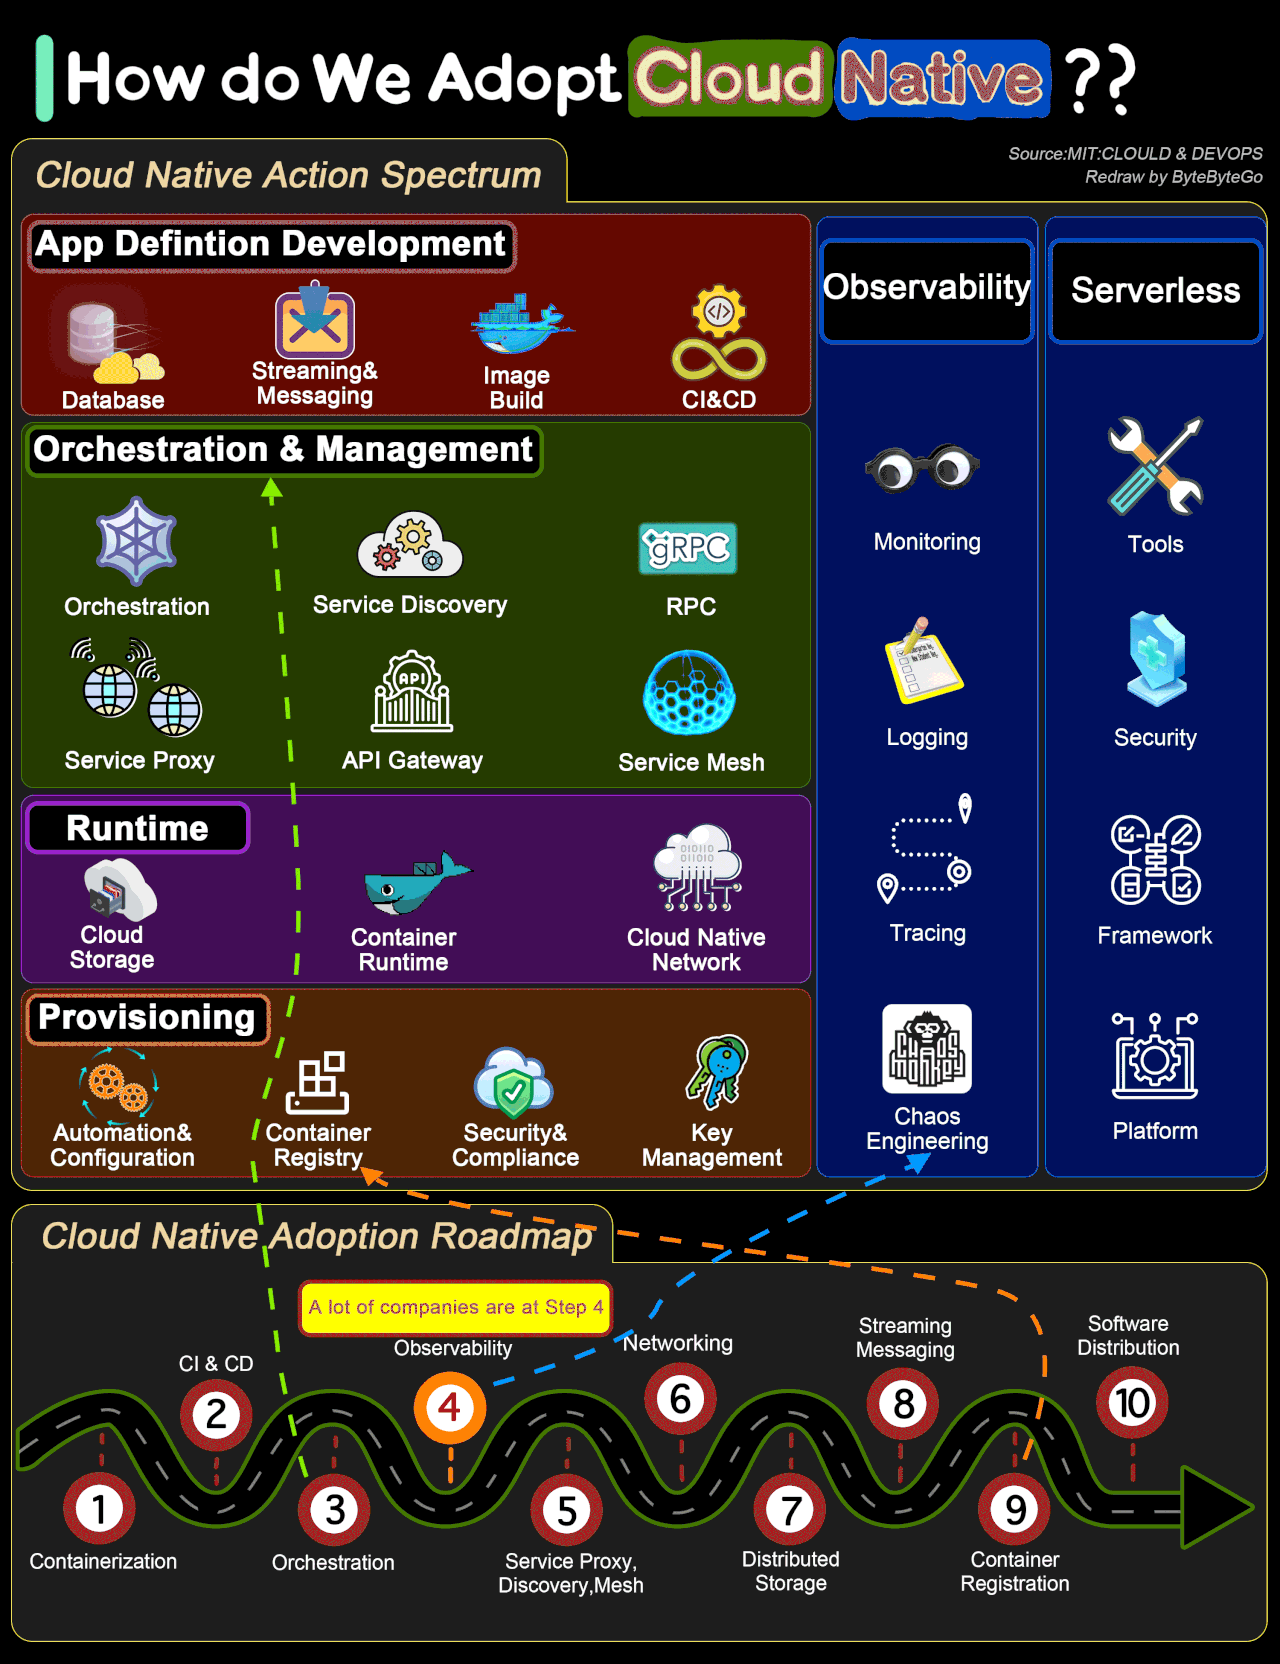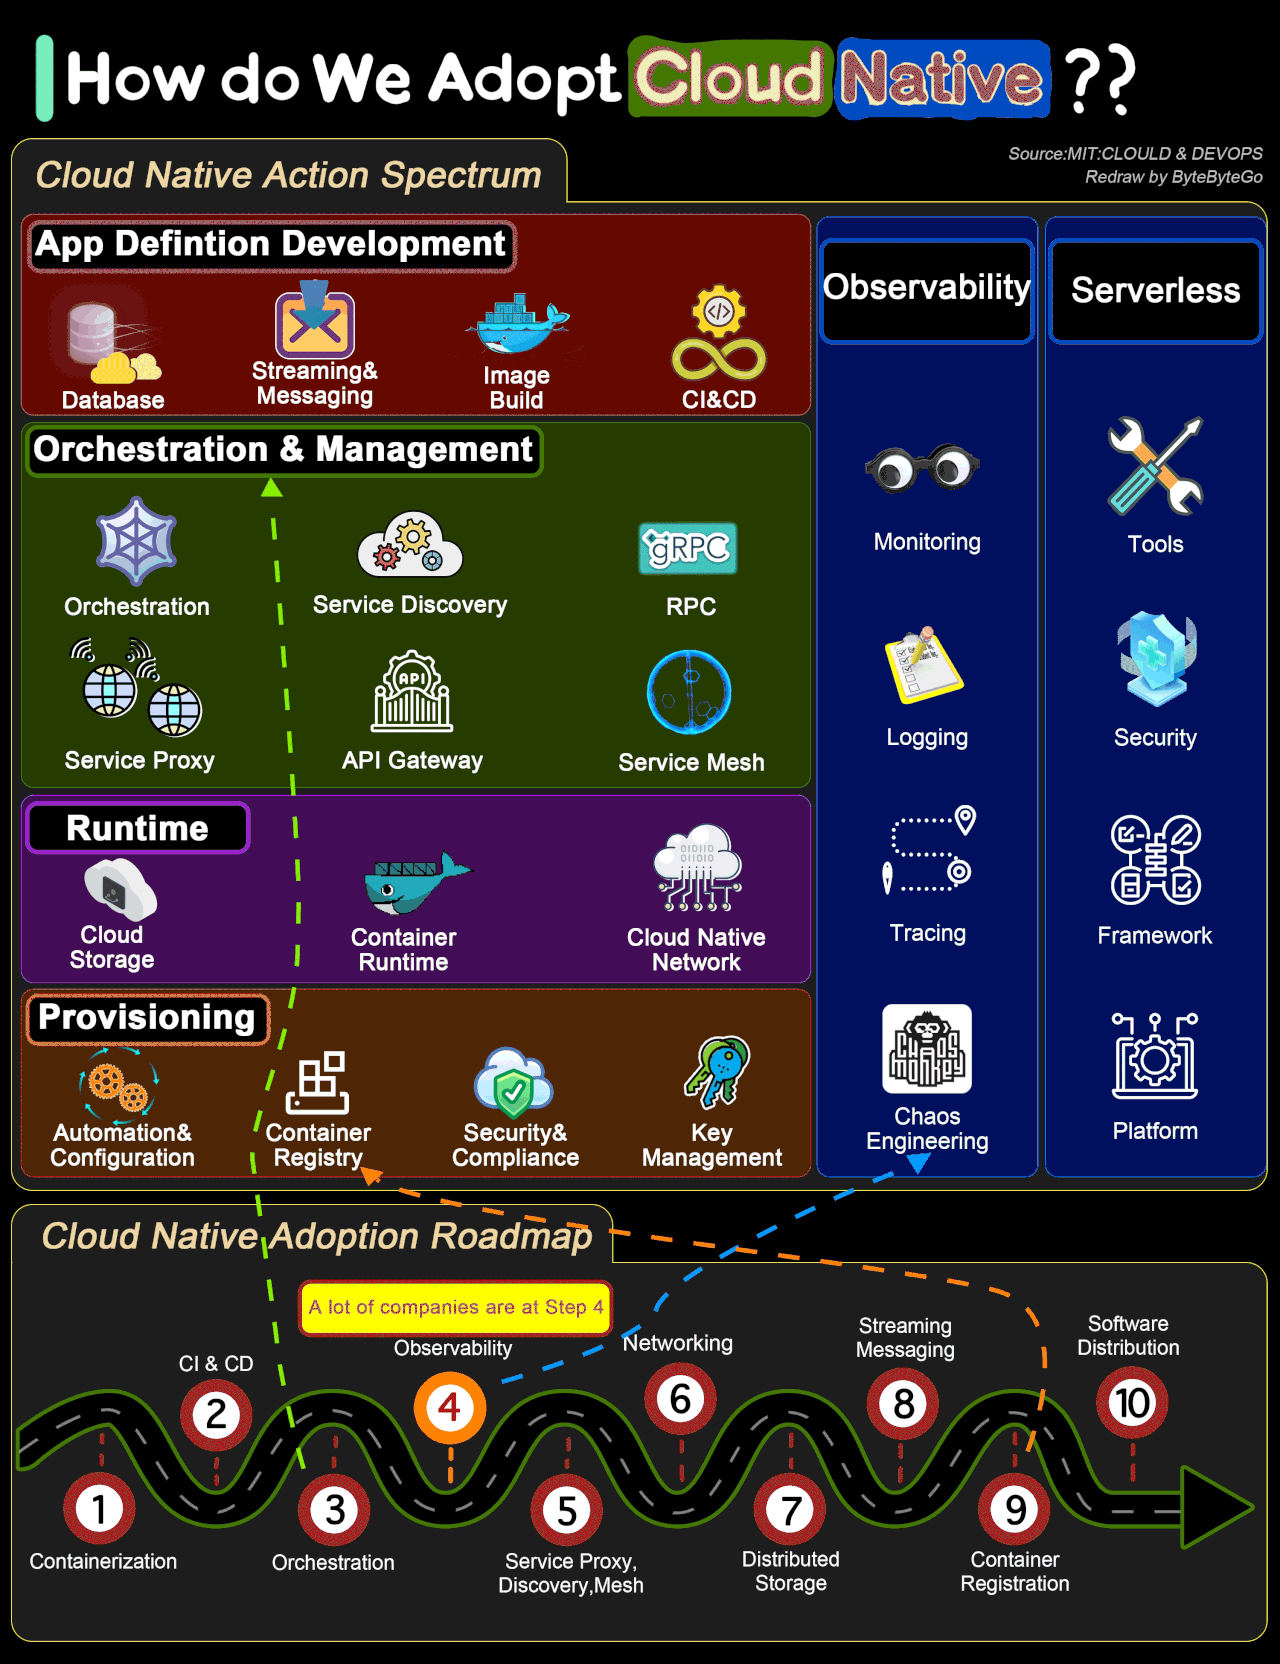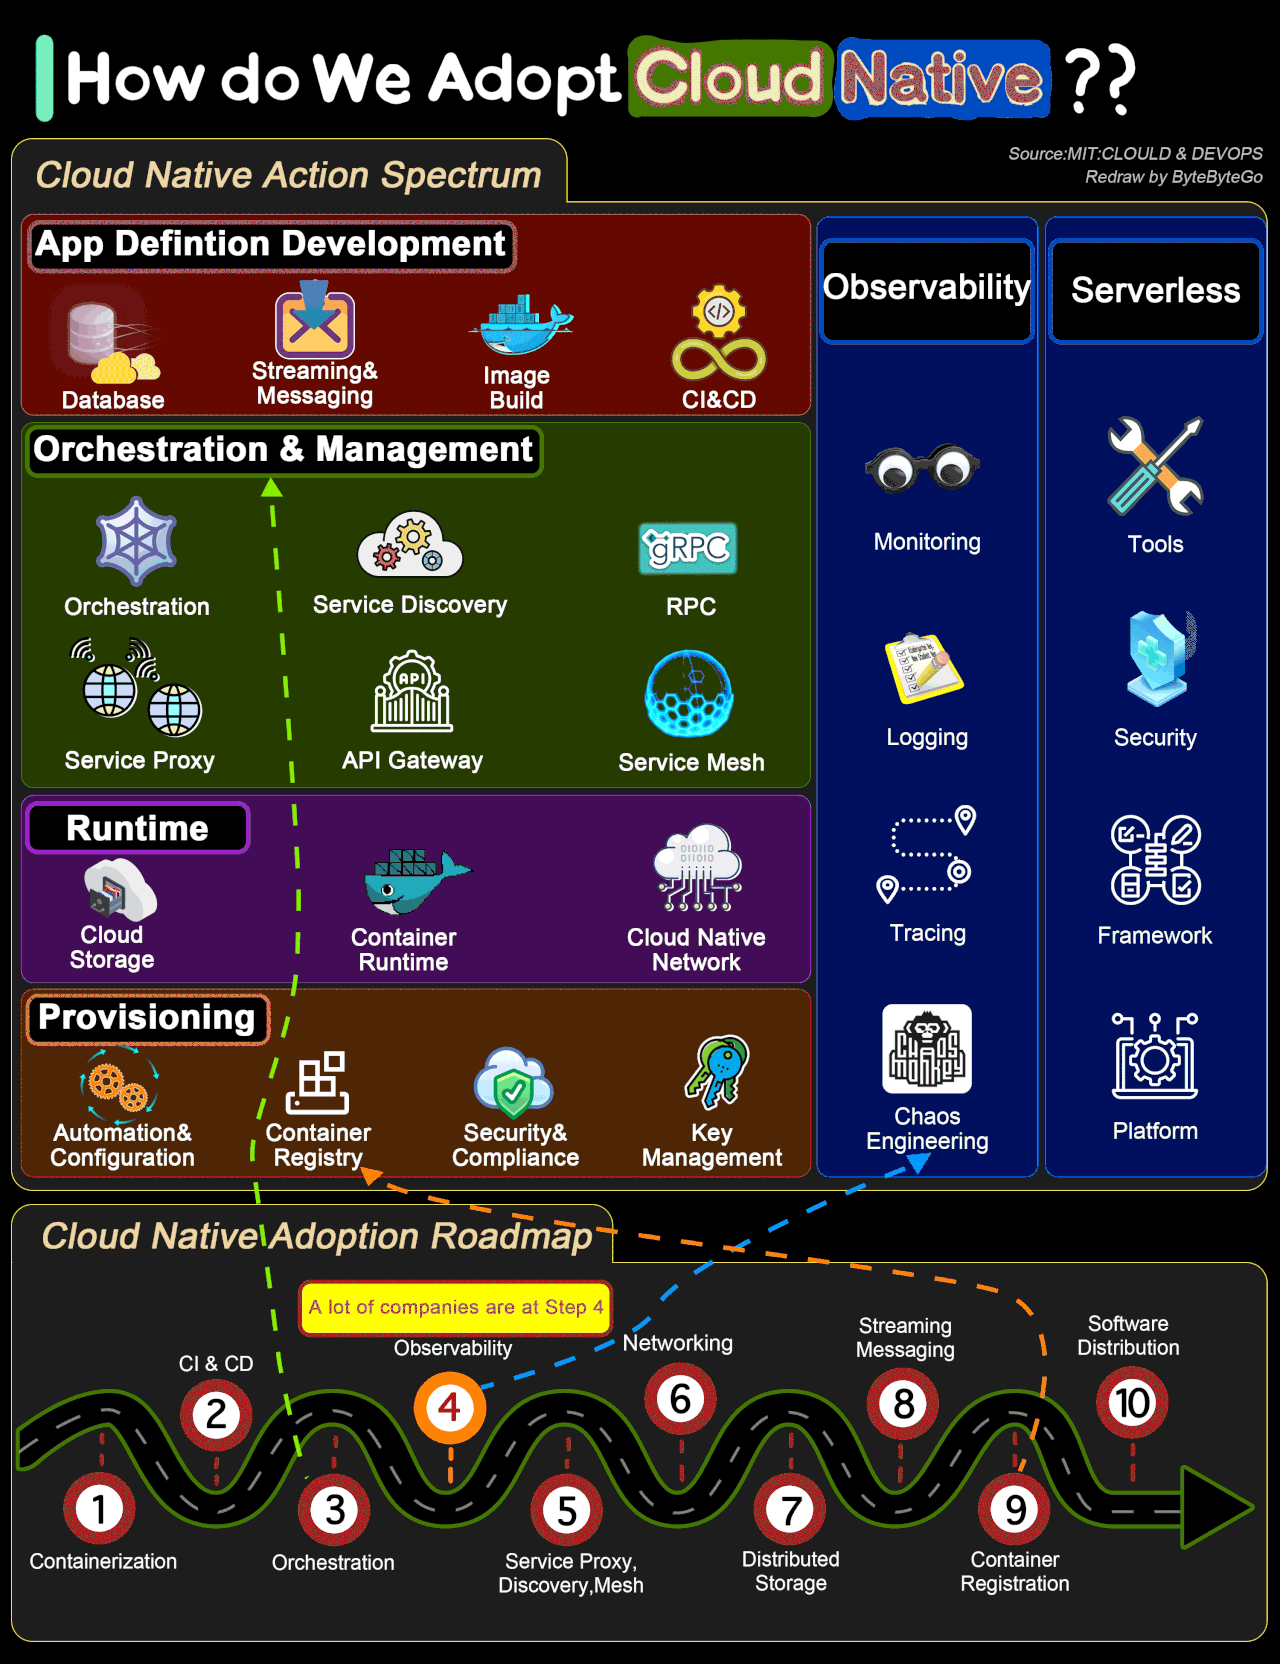
Diagram ByteByteGo membagi pembahasan ini ke enam area dan menyertakan roadmap adopsi. Saya memakainya sebagai peta untuk memahami tanggung jawab setiap lapisan, lalu menilai bagian mana yang perlu diperbaiki lebih dahulu. Penjelasan di bawah merupakan sintesis saya dengan rujukan CNCF, NIST, Google SRE, dan kajian serverless dari Berkeley.
Ada beberapa batas pembacaan yang perlu dijaga:
- Lokasi hosting belum menjelaskan cara kerja sistem. Definisi CNCF mencakup lingkungan public, private, dan hybrid cloud serta menekankan ketahanan, kemudahan pengelolaan, observability, dan otomatisasi.
- Roadmap adalah saran penerapan. CNCF sendiri mengakui banyak jalur adopsi. Posisi observability dalam gambar tidak menjadi alasan menunda pemantauan.
- Serverless perlu dinilai per kebutuhan. Memilihnya berarti mengubah pembagian tanggung jawab operasional dengan penyedia platform.
Peta singkat
Area | Pertanyaan utama |
Pengembangan aplikasi | Bagaimana kode, data, dan artefak rilis disiapkan? |
Orkestrasi dan manajemen | Bagaimana workload ditempatkan dan layanan saling menemukan? |
Runtime | Bagaimana aplikasi berjalan dan mengakses jaringan serta penyimpanan? |
Provisioning | Bagaimana lingkungan disiapkan secara konsisten dan aman? |
Observability | Bagaimana kondisi dan gangguan layanan diketahui? |
Serverless | Bagian operasional mana yang diserahkan kepada platform? |
1. Pengembangan aplikasi: siapkan proses rilis yang dapat diulang
Pada diagram, area ini mencakup database, streaming dan messaging, image build, serta CI/CD. Artinya, perhatian kita mencakup cara aplikasi dibangun sekaligus dependensi data yang dibutuhkannya.
Google SRE menekankan bahwa layanan yang andal memerlukan proses rilis yang andal: build dan konfigurasi harus dihasilkan secara otomatis dan dapat direproduksi. NIST menjelaskan alur image dari pengembangan, pengujian, registry, hingga deployment. Kedua rujukan ini membantu menghubungkan kode dengan artefak yang benar-benar berjalan.
Sebagai contoh rancangan, saya akan meminta pipeline membangun image, menjalankan pengujian, memeriksa kerentanan, lalu menyimpan artefak yang lolos ke registry dengan identitas yang dapat ditelusuri. Sebelum produksi, tim perlu mengetahui versi apa yang akan dirilis dan bagaimana kembali ke versi sebelumnya. Ini contoh penerapan, bukan laporan migrasi yang pernah saya lakukan.
Risikonya terletak pada kepercayaan terhadap artefak. Image yang pernah aman dapat menjadi rentan ketika celah pada dependensinya ditemukan. Pemeriksaan dan pembaruan perlu menjadi pekerjaan berulang. Rujukan: Google SRE, bab Release Engineering; NIST SP 800-190, bagian 2.3 dan 3.1.
2. Orkestrasi dan manajemen: kelola penempatan dan komunikasi
Orchestrator menerima kebutuhan workload, memilih host yang memiliki sumber daya, lalu menjalankan container. NIST juga menjelaskan kemampuan restart pada host lain, service discovery, dan pengaturan jaringan, bergantung pada konfigurasi platform.
Contoh sederhananya adalah layanan web dengan beberapa replika. Tim menentukan kebutuhan sumber daya dan jumlah replika, sedangkan orchestrator mengatur penempatannya. Namun, proses yang hidup kembali belum membuktikan bahwa fungsi bisnisnya sudah pulih. Karena itu, saya akan menilai hasil pemulihan melalui pemeriksaan layanan dari sisi pengguna.
Diagram juga memuat service proxy, API gateway, RPC, dan service mesh. Saya membacanya sebagai area komunikasi yang perlu dipahami sebelum memilih komponen. Untuk implementasi container kecil dan sederhana, NIST bahkan menyebut orchestrator lengkap dapat tidak diperlukan.
Risiko pentingnya adalah hak akses: akun administrator yang terlalu luas dapat memengaruhi seluruh workload. Batasi kewenangan sesuai kebutuhan dan pisahkan akses antaraplikasi. Rujukan: NIST SP 800-190, bagian 2.3.3 dan 3.3.
3. Runtime: periksa host, jaringan, dan data
Container runtime menjalankan aplikasi dari image. Lingkungan eksekusinya tetap bergantung pada host serta akses jaringan dan penyimpanan. NIST mengingatkan bahwa container berbagi kernel host; kerentanan runtime atau konfigurasi yang keliru dapat memperluas dampak serangan.
Contohnya, memindahkan container ke host lain menimbulkan pertanyaan tentang data: apakah data yang dibutuhkan masih tersedia dan aksesnya tetap dibatasi? NIST menegaskan bahwa volume yang digunakan workload perlu dapat diakses dari lokasi eksekusinya.
Dalam evaluasi, saya akan menelusuri lokasi penyimpanan data, jalur koneksi database, hak akses proses, dan prosedur pemulihan. Untuk data penting, rencana migrasi perlu menyertakan backup serta pengujian pemulihannya sebelum perpindahan produksi.
Jangan menganggap keberhasilan menjalankan image sebagai bukti seluruh lingkungan siap. Rujukan: NIST SP 800-190, bagian 3.3.2, 3.4, dan 3.5.
4. Provisioning: jadikan keamanan bagian dari penyiapan
Diagram memasukkan otomatisasi konfigurasi, registry, security dan compliance, serta key management ke area provisioning. Saya melihatnya sebagai pengingat bahwa penyiapan lingkungan juga menentukan siapa yang dipercaya dan apa yang boleh diakses.
NIST memberi contoh risiko konkret: password database atau private key yang dimasukkan ke image dapat dibaca oleh pihak yang memperoleh image tersebut. Registry pun perlu autentikasi, otorisasi, dan koneksi yang aman karena menjadi sumber software bagi lingkungan eksekusi.
Contoh aturan penerapan yang saya sarankan: pisahkan secret dari image, batasi akses registry dan cluster, serta tinjau perubahan konfigurasi melalui proses yang tercatat. Otomatisasi harus membawa aturan akses yang benar, sebab kesalahan konfigurasi juga dapat diperbanyak secara konsisten.
Rujukan: NIST SP 800-190, bagian 3.1.4, 3.2, dan 4.3.
5. Observability: ukur dampak pada pengguna
Diagram menyebut monitoring, logging, tracing, dan chaos engineering. Untuk memulai, saya akan memilih pertanyaan operasional yang jelas: apakah request berhasil, berapa lama responsnya, dan apakah kapasitas mendekati batas?
Google SRE menyarankan empat sinyal utama: latency, traffic, errors, dan saturation. Pengukuran dari dalam sistem membantu diagnosis, sedangkan pemeriksaan dari luar membantu melihat gejala yang dialami pengguna.
Contohnya, grafik CPU rendah belum cukup untuk menyatakan layanan sehat jika request gagal karena koneksi database. Alert sebaiknya mengarah pada masalah yang membutuhkan tindakan, dengan informasi yang membantu petugas menanganinya. Terlalu banyak alert dapat menutupi gangguan yang sebenarnya.
Saya akan menyiapkan pengukuran dasar sebelum migrasi agar kondisi sesudah perubahan dapat dibandingkan. Rujukan: Google SRE, bab Monitoring Distributed Systems.
6. Serverless: tentukan batas tanggung jawab
Kajian Berkeley tahun 2019 menjelaskan serverless sebagai pendekatan yang menyerahkan sebagian besar administrasi sistem kepada platform. Kajian tersebut juga membahas keterbatasan serta tantangan penerapannya.
Sebagai contoh evaluasi, pemrosesan file setelah unggahan dapat dipertimbangkan sebagai fungsi yang dipicu event. Sebelum memilih platform, saya akan memeriksa batas eksekusi, perilaku ketika fungsi mulai berjalan, akses data, biaya, dan ketergantungan pada layanan penyedia. Kecocokannya perlu diuji pada workload tersebut.
Pengelolaan infrastruktur oleh platform tetap memerlukan keputusan aplikasi dari tim: data apa yang diproses, siapa yang boleh memanggil fungsi, dan bagaimana kegagalan ditangani. Rujukan: Cloud Programming Simplified: A Berkeley View on Serverless Computing.
Mulai dari satu perubahan yang dapat dinilai
Urutan penerapan yang saya sarankan dimulai dari pemetaan aplikasi dan dependensinya, pengukuran kondisi awal, lalu perbaikan proses build serta rilis. Setelah itu, pilih satu workload terbatas untuk mencoba perubahan lingkungan dan menguji pemulihannya.
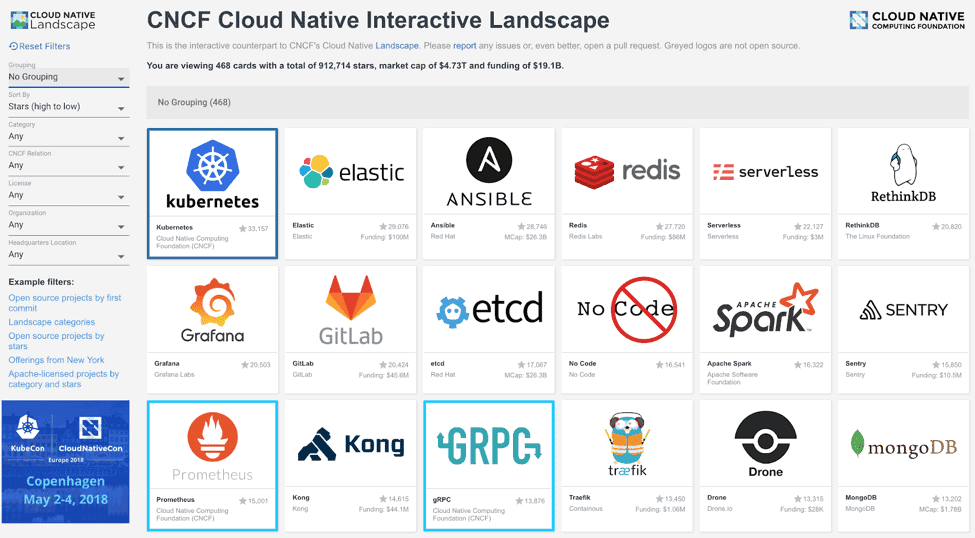
Tambahkan orkestrasi, pola komunikasi, atau serverless ketika kebutuhan dan manfaatnya sudah dapat dijelaskan. CNCF memperkenalkan landscape sebagai peta teknologi dan trail map sebagai panduan perjalanan; keduanya membantu memilih arah, bukan menggantikan penilaian terhadap sistem sendiri.
Bagi saya, hasil transformasi perlu terlihat pada pekerjaan sehari-hari: rilis dapat ditelusuri, gangguan dapat diketahui, dan tanggung jawab pemulihan jelas. Enam area tadi berguna jika dibaca sebagai bagian yang saling berhubungan dalam satu sistem.